Voir un robot atteindre une sortie ne dit pas s’il a appris, suivi une règle ou eu de la chance. C’est le problème que j’ai pris en charge avec SupraLab AI.
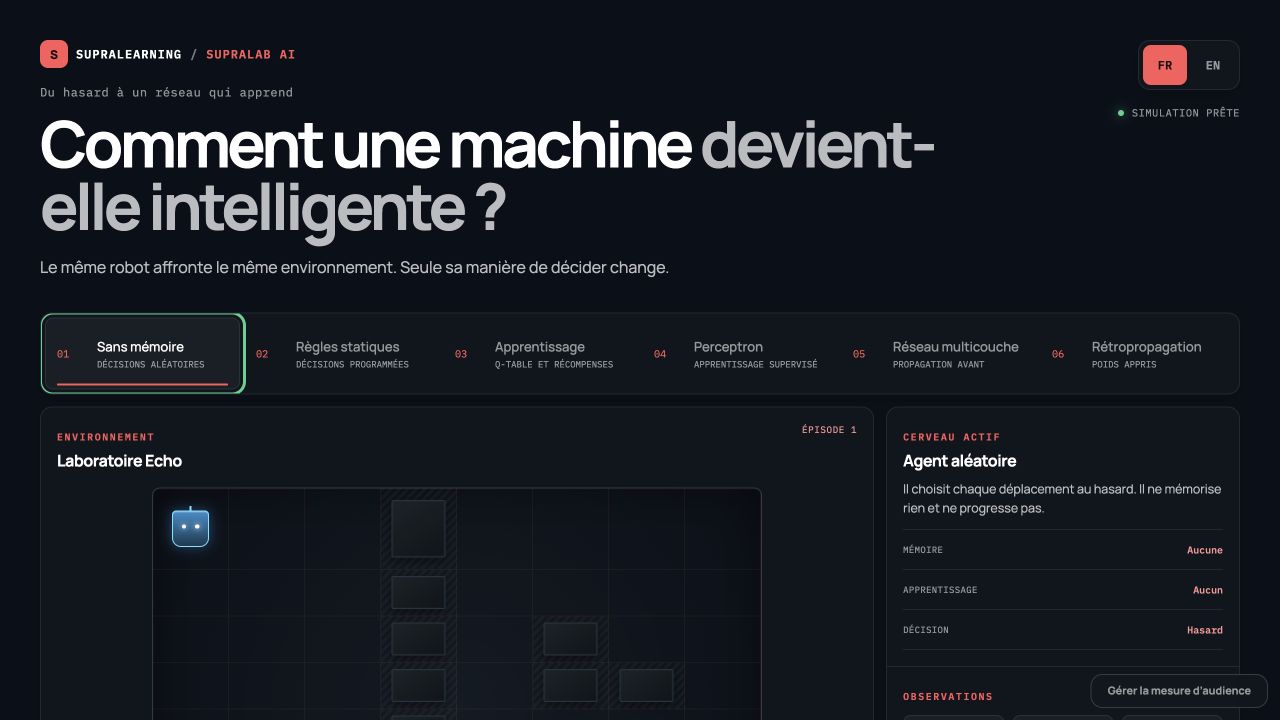
J’ai conçu le laboratoire autour d’un même robot et d’un même environnement. Seule la manière de décider change. L’utilisateur peut alors comparer le hasard, les règles, le Q-learning, le perceptron, un réseau multicouche et la rétropropagation sans perdre ses repères entre deux démonstrations.
2–3 octobre 2026 / Garder les signaux, ajouter la reprise
J’ai adopté les surfaces graphite, cuivre et cyan des labs, réorganisé les six niveaux sur téléphone et placé l’étape active avant la carte complète du cours agents.
Le connecteur de compte restaure la simulation et le cours. Les modes explorés, modules, défis et révisions alimentent le passeport. Les réponses tardives après un changement de compte sont ignorées. Ces évolutions sont vérifiées localement.
01 / Cadrage produit
Partir d’une confusion précise
Le mot « intelligence » masque facilement le mécanisme. Mon objectif était de permettre à une personne de répondre à trois questions après chaque niveau : d’où vient la décision, que conserve l’agent et qu’est-ce qui change quand il s’entraîne ?
J’ai donc cherché une trace lisible entre un état, une action, une conséquence et la décision suivante, plutôt qu’une démonstration de performance.
- Le niveau aléatoire ne mémorise rien.
- L’agent symbolique applique des règles écrites à l’avance.
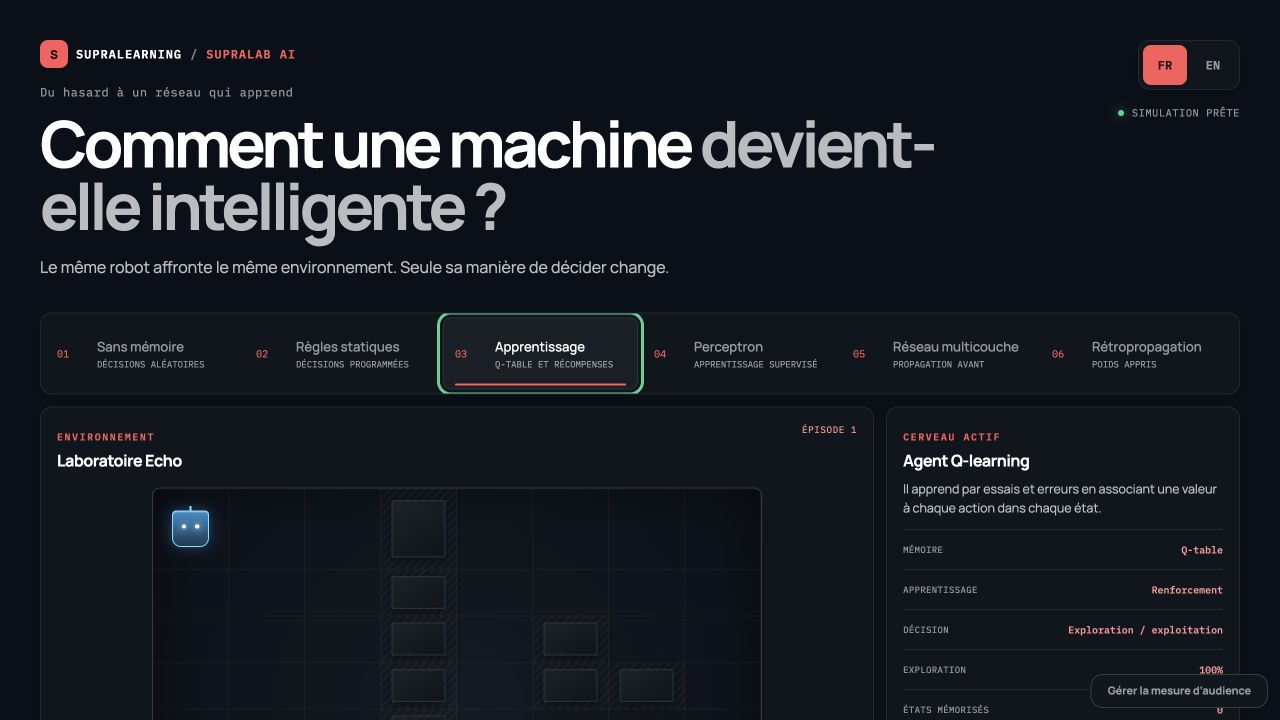
- Le Q-learning modifie une table à partir des récompenses.
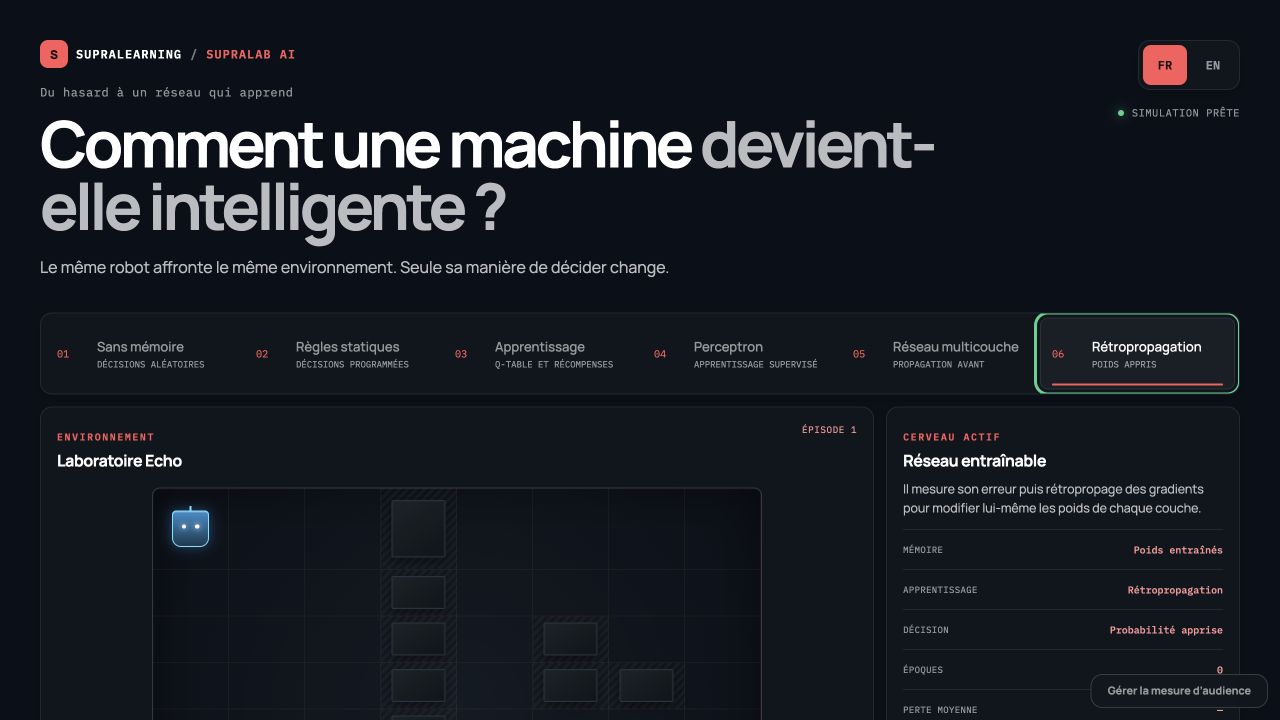
- Les réseaux transforment des entrées en scores, puis ajustent leurs poids au dernier niveau.
02 / Dispositif comparatif
Garder une variable stable pour voir ce qui change
Le laboratoire Atlas conserve une grille de 10 × 10 cases, 27 obstacles et un trajet de référence de 18 pas. Les six agents partent du même point, cherchent la même sortie et utilisent les mêmes commandes. Cette contrainte rend la comparaison plus honnête : une différence de comportement vient de l’agent, pas d’une nouvelle carte.
Des environnements distincts auraient permis des scènes plus variées. Ils auraient aussi demandé de réapprendre les obstacles, la légende et l’objectif à chaque niveau. J’ai préféré investir cette attention dans la décision elle-même.
La simulation fonctionne pas à pas ou automatiquement, avec quatre vitesses. Le pas manuel sert à inspecter un calcul. L’exécution accélérée sert à observer une stratégie sur plusieurs épisodes.
03 / Progression
Introduire la complexité par paliers
Les six niveaux forment une progression continue. Le hasard établit le point de comparaison. Les règles montrent qu’un comportement cohérent peut être entièrement programmé. Le Q-learning introduit l’exploration, la récompense et la mémoire. Le perceptron fait apparaître les entrées et les poids. Le réseau multicouche ajoute une couche cachée. La rétropropagation montre enfin comment l’erreur modifie ces poids.
Chaque niveau prépare le vocabulaire du suivant avec un comportement déjà observé. La personne rencontre une Q-value après avoir vu une récompense, puis un gradient après avoir vu une erreur se propager.
04 / UX de simulation
Relier chaque déplacement à sa décision
La grille montre le résultat. Les panneaux de décision montrent sa cause. Selon le niveau, l’interface expose le nombre aléatoire tiré, les règles testées, les actions disponibles, les Q-values, le choix entre exploration et exploitation, les entrées du perceptron, les activations du réseau, la perte et les gradients.
J’ai relié ces valeurs au pas courant. Quand le robot heurte un obstacle, reçoit une pénalité ou réduit sa distance à la sortie, le panneau conserve le calcul qui a conduit à cette action. L’utilisateur peut comparer ce que l’agent savait avant le geste et ce qu’il met à jour après.
L’entraînement accéléré reste disponible pour voir une tendance. Le pas-à-pas reste le mode d’inspection, car une animation rapide peut donner une impression de compréhension tout en cachant le calcul.
05 / Pédagogie
Relier manipulation, explication et vérification
Chaque niveau associe la simulation à un cours. Le texte reprend les variables déjà vues dans le laboratoire, explique les forces et les limites de l’approche, puis prépare la transition suivante. Une question invite à formuler une réponse avant d’ouvrir l’explication.
Cette continuité évite deux expériences parallèles, avec une animation d’un côté et un cours abstrait de l’autre. Les mêmes mots désignent l’état, l’action, la récompense, les poids ou l’erreur dans le panneau et dans l’explication.
Le niveau sur la rétropropagation relie la propagation avant, la fonction de perte, les gradients et la descente de gradient. Les modèles restent volontairement petits afin que leurs valeurs puissent encore être lues à l’écran.
06 / Architecture et accès
Séparer le monde, les agents et l’interface
GridWorld possède la carte, les déplacements, les collisions et les récompenses. Chaque agent implémente sa propre décision dans une classe TypeScript testable. React orchestre le niveau actif, la simulation, les panneaux et le cours. Cette séparation me permet de comparer les algorithmes dans les mêmes conditions et de vérifier leur logique sans rendre l’interface.
Le produit fonctionne entièrement dans le navigateur. La progression et l’état d’entraînement utile sont conservés localement. Ce choix réduit l’infrastructure, mais limite la reprise à l’appareil utilisé.
L’accessibilité fait partie du dispositif pédagogique. Les niveaux se parcourent avec les flèches, Home et End. La position du robot et la sortie ont une description textuelle. Les changements importants sont annoncés sans interrompre la navigation. Les douze combinaisons de niveau et de langue sont auditées avec axe-core, avec un contrôle visuel séparé pour le contraste.
07 / Mesure
Ce que le produit démontre aujourd’hui
La version en ligne permet de comparer six modes de décision, inspecter leurs calculs, entraîner les modèles qui apprennent et parcourir les cours en français ou en anglais. Les agents, l’environnement, la persistance et les parcours clavier sont couverts par des tests dans le dépôt.
Je ne dispose pas de mesure publique sur la compréhension ou le transfert après une session. Le laboratoire prouve une expérience fonctionnelle et testable. L’efficacité pédagogique demande encore une observation dédiée.
- La capacité à distinguer une règle programmée d’un apprentissage.
- La capacité à prédire la prochaine action avant de lancer un pas.
- La compréhension du rôle d’une récompense, d’un poids et d’un gradient.
- La restitution du mécanisme avec un exemple différent du labyrinthe.
08 / Recul
Ce que je testerais plus tôt
Je commencerais par les trois premiers niveaux. Le hasard, les règles et le Q-learning suffisent pour vérifier si la comparaison commune aide réellement à comprendre la différence entre comportement programmé et comportement appris.
Je demanderais aussi une prédiction avant certains pas. Choisir l’action attendue, puis comparer avec la décision de l’agent, produirait une preuve plus forte qu’un bouton « compris ». Les niveaux de réseaux arriveraient seulement après validation de cette première boucle.
La prochaine étape consiste à observer si une personne novice peut expliquer, sans l’interface, pourquoi les six agents ne prennent pas leurs décisions de la même manière.